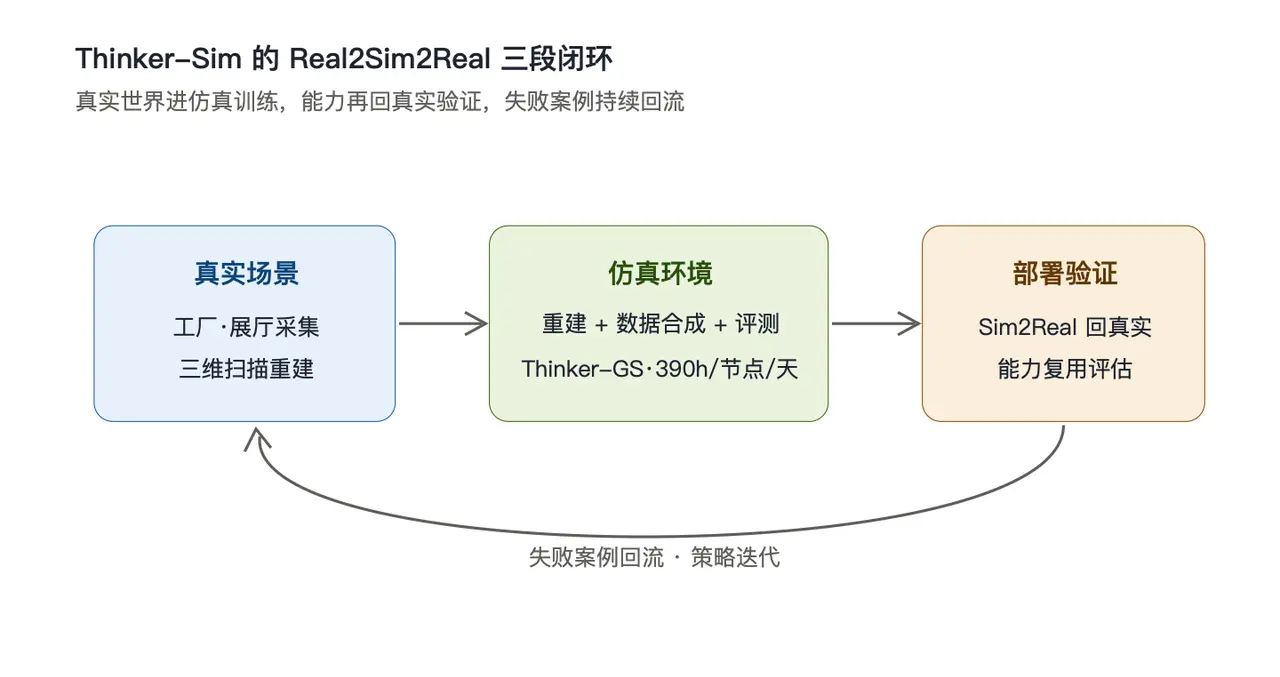
11月2日, 优必选 正式发布具身智能仿真平台Thinker-Sim。它的内核是Real2Sim2Real:把真实工厂、商业展厅扫描重建为三维仿真环境,让机器人在虚拟世界里训练、测试,再把学到的能力放回真实场景验证。一句话概括,它是覆盖“真实场景数字化—规模化仿真数据合成—机器人能力评测”的一站式技术体系。
这个平台瞄准的是行业公认的共性难题:真实数据采集成本高、仿真环境构建复杂、算法验证周期长。 优必选 在发布材料里点明了一个朴素事实——真机数据靠机器人一台台跑,成本和速度都有天花板,仿真因此正成为规模化训练数据的主要来源。把这句话翻成产业语言:数据不够,已经不是“多买几台机器人”能解决的问题,而是“怎么把造数据这件事工业化”。
真机数据有天花板
过去两年,具身智能的数据叙事几乎都围绕“真实”展开。先是数据飞轮——靠遥操作采集真机轨迹,让机器人从人类示范里学;接着是数据供应商——把采集、标注、清洗后的训练数据按条、按小时对外售卖,简智单季度交付已冲到百万小时,机器科学把单条数据成本压到0.05元。这条路线解决的是“数据的量”,但没解决“数据的边际成本”:真实数据每多一小时,都要真机、真人和真实场景的边际投入。
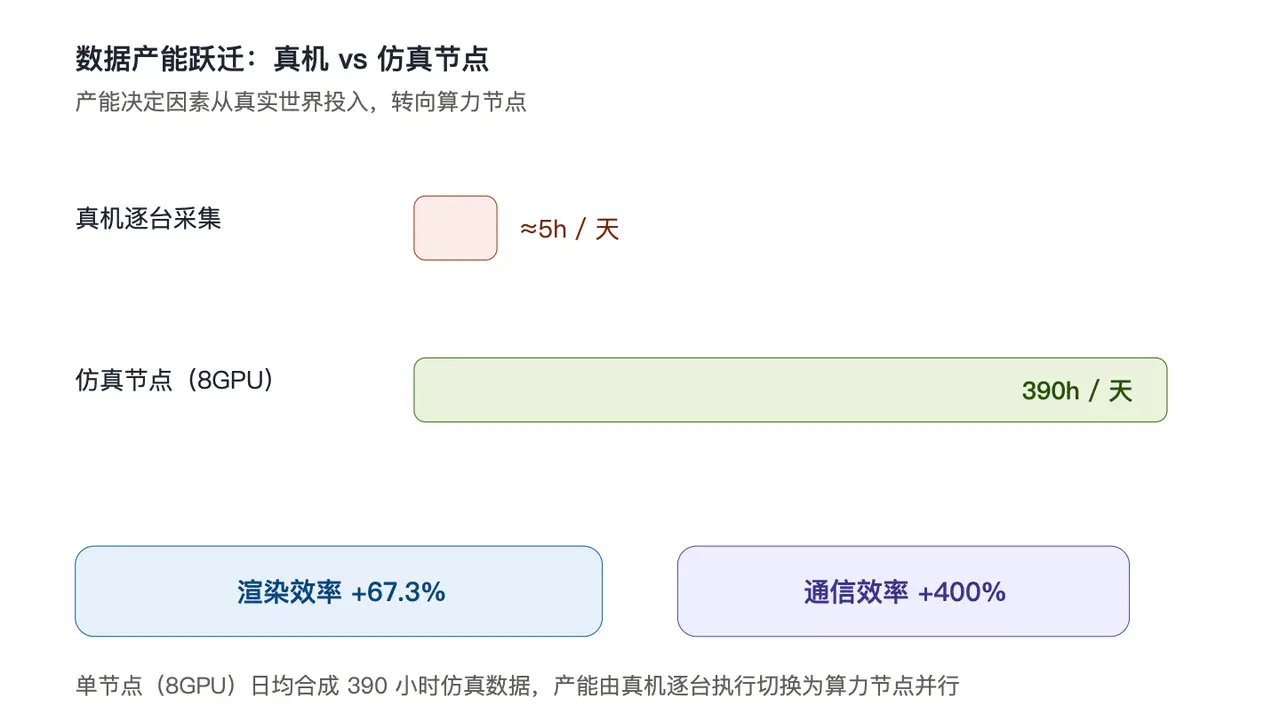
仿真走的是另一条路。它不需要真机在物理世界里逐帧执行,而是在数字孪生环境里批量生成。Thinker-Sim给出的数字很有代表性:自研渲染引擎让渲染效率提升67.3%,单节点(8GPU)日均可合成390小时仿真数据,自研SIL/HIL通信模块把通信效率再抬升超过400%。换句话说,数据产能从“一台机器人一天产出几小时”切换成了“一个算力节点一天产出近400小时”。
Thinker-Sim的三段闭环
平台的能力拆成三段。第一段是场景重建与资产生成:依托自研Thinker-GS高保真场景重建算法和SimReady资产自动化生成,把真实工厂、商业展厅重建出空间布局和视觉细节,再按需加载机器人、设备、人员等前景资产,快速组装成可交互的仿真环境。
第二段是仿真数据合成:靠高性能渲染引擎加大规模并行仿真架构,把“造数据”变成高吞吐的流水线。前面提到的390小时/节点/天,正是这段的产能锚点。
第三段是机器人能力评测:搭建面向感知、导航、操作等任务的统一仿真评测体系,通过场景、光照、纹理、材质的多维度随机化,复现真实世界的不确定性,评估算法的鲁棒性和泛化能力。它回答的问题是——模型在仿真里考了高分,到了真实环境还能不能打。
在易用性上,Thinker-Sim也做了降低门槛的设计:内置标准化仿真任务模板,一键启动并实时推流画面;可视化工作流支持零代码编排,官方称可适配90%以上目标场景;自研Ulab-Agent则用自然语言完成场景创建、环境配置和任务调度。本体厂把仿真从“研究院工具”往“工程平台”推的意图很明显。
本体厂为什么伸手数据层
把Thinker-Sim放进更大的棋盘看,它不只是 优必选 给自己机器人用的内部工具,而是本体厂向上游“数据基础设施”伸手的一个信号。 NVIDIA 的Isaac Sim早已是这个赛道的既定存在,它把仿真、合成数据、策略训练打包进机器人开发栈;当本体厂也开始自研高保真仿真平台,意味着“谁掌握训练数据的生产工具”正在成为竞争的新前线。
这也让具身智能的数据供给第一次清晰地分出三种形态:第一种是真实采集(数据飞轮),靠真机和遥操作积累轨迹;第二种是外采数据(数据供应商),按条、按小时向专业公司购买;第三种是自研仿真(数据工厂),把数据生产搬进数字孪生环境并行生成。前两种的边际成本都跟着真实世界走,第三种第一次让数据产能主要由算力节点决定。无论是 宇树 、 智元 这类本体厂,还是 特斯拉 、 Figure 这样的整机与模型玩家,都绕不开训练数据的规模化压力。
对本体厂而言,三条路线不是互斥,而是组合。真实数据保证长尾和真实分布,外采数据补量和提速,仿真数据做规模和泛化预训练。但组合背后是路线选择:是像机器科学、简智那样把数据交给外部供应商,还是像 优必选 这样把仿真引擎握在自己手里。前者轻、快,后者重、可控,且和自家机器人的构型、任务深度绑定。
值得警惕的是,仿真数据的价值边界还没被第三方验证。Thinker-Sim的性能数字来自优必选自身,目前没有独立测试结果;机器人圈常说的sim-to-real差距——仿真里练得再好,真实世界里传感器噪声、执行器延迟、接触力不确定性都会让表现打折——依然存在。仿真能放大数据规模,却替代不了真实长尾里那些“没想到会发生”的瞬间。
所以这个平台真正的考卷不在发布会,而在工厂和展厅的复购与续训里:用Thinker-Sim训出来的策略,回到真实机器人上能保留多少能力,能否持续把真实部署里的失败案例回流成新的仿真场景。Real2Sim2Real的“2Real”那一半,才是决定它算不算“基础设施”的关键。
从数据飞轮到数据供应商,再到今天的仿真工厂,具身智能一年多来的主线之一,是把“训练数据从稀缺资源变成可规模化生产的工业品”。 优必选 这一步未必是路线终局,但它把“本体厂要不要自己造数据”这个选择题,摆到了台面上。本文基于公开报道整理。