11月9日,在机器人学习大会CoRL 2026上, 英伟达 发布新一代机器人基础模型GR00T 2。表面看是一次例行升级,但它把机器人模型从“视觉-语言-动作”(VLA)推进到了“世界-动作”(WAM)——模型不再只依据当前画面直接输出动作,而是先在内部“想象”物理世界将如何演化,再驱动执行。这一步,很可能比参数规模更值得记。
先说清楚VLA为什么够用又不够用。过去两年主流做法是:给模型看一眼当前画面、读一句指令,它直接给出下一步动作。逻辑直接、落地快, 宇树 、 Figure 、 特斯拉 的Optimus都把这类路线当作走向实用的核心。问题也在这儿:它只对“当下”负责,不预测“接下来”。一旦任务需要多步衔接,或者环境会反过来影响机器人自己,单帧决策就容易在第三步掉链子。
WAM改的是这件事的顺序。GR00T 2先联合预测“未来视频帧”和“机器人动作序列”——也就是先把接下来几帧世界长什么样、自己该动成什么样一起推出来,再据此驱动夹爪、灵巧手和人形机器人。模型在动之前,先在自己的表征里跑了一遍“预演”。
支撑这套变化的,是一个约20亿参数的扩散Transformer,基于 英伟达 的Cosmos视频模型初始化。它的输入是0.8秒的多视角视频、机器人本体状态和一句语言指令,输出则是未来观测与动作块,再以闭环方式持续校正。把“视频生成”和“动作生成”塞进同一个骨干,是这次架构最实在的改动。
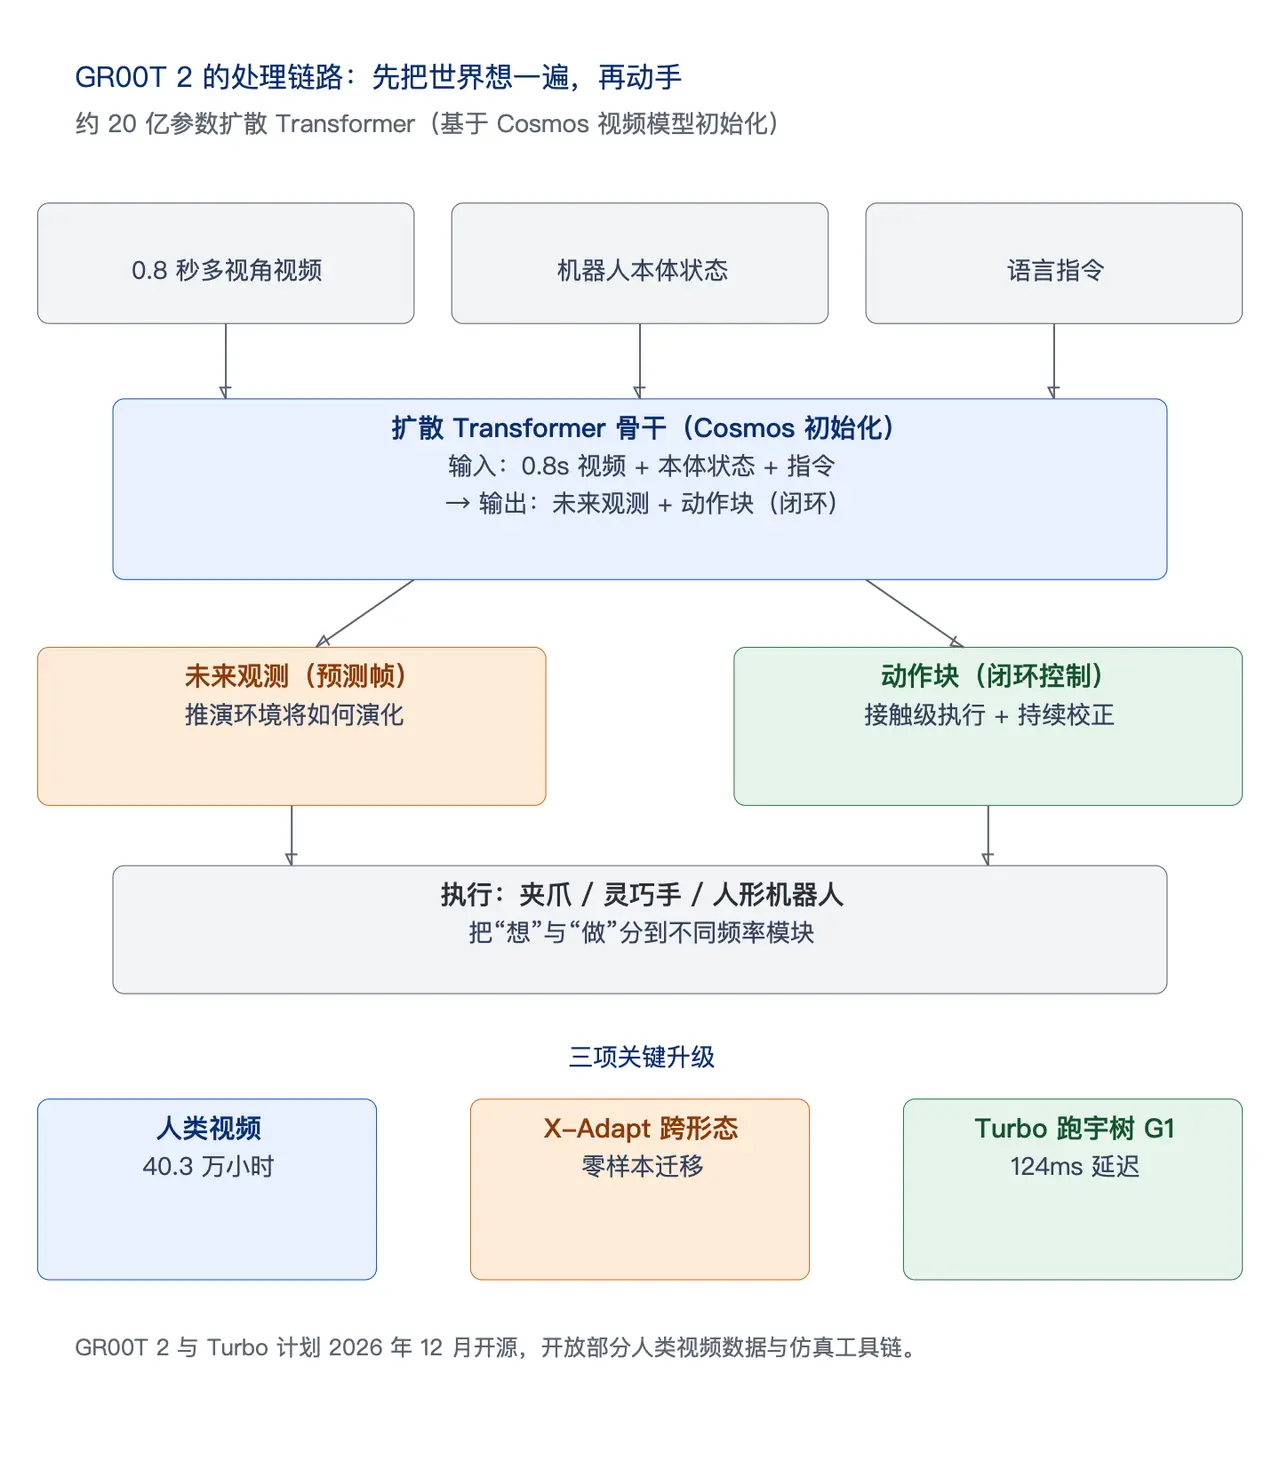
更值得拆的是三个具体升级。第一,“借人类经验学物理”:训练混合了40.3万小时人类第一视角视频、1万小时UMI手持数据和2.35万小时遥操作数据,而且公开口径称“人类视频占比越高,真机成功率线性抬升”——等于把海量人类录像变成了机器人的物理课。
第二,“X-Adapt跨形态迁移”。人类穿戴设备、UMI、DexUMI外骨骼示范学到的技能,可以零遥操作迁移到没练过的机器人身上;在50项未知任务上,零样本平均成功率40%,给1条示范后升到71%,给5条示范后达到95%。这条曲线,比任何参数表都更能说明“示范学习”的边际成本在快速下降。
第三,“预训练+强化学习+智能体”的分层。轻量版GR00T 2 Turbo可以跑在 宇树G1 机载的Jetson Thor上,推理延迟约124毫秒;一个推理智能体负责任务拆解与纠错,GR00T 2本身只做接触级的执行。把“想”和“做”分到不同频率的模块,是工程上能上机的关键。
把镜头拉回全行业,WAM不是 英伟达 一家的孤例。11月10日,谷歌DeepMind发布Gemini Robotics 2.5,称其为迄今能力最强的VLA;11月12日,华为云定档11月16日发布昇腾原生具身世界模型CloudRobo-WM1.2; 智元 的GO-3与WITA-OMNI、 优必选 的Thinker-Sim,也都在把“世界模型/仿真”当作大脑的底座来投入。
背后的共识很清楚:机器人大脑正在从单点模型走向分层基础设施。世界模型负责推演环境与行动结果,VLA负责把视觉和语言转成动作,底层控制模型保证接触、平衡和执行器的稳定。三者协同,模型才不只是贴在硬件上的识别模块,而开始成为技能获取和持续学习的共同基础。
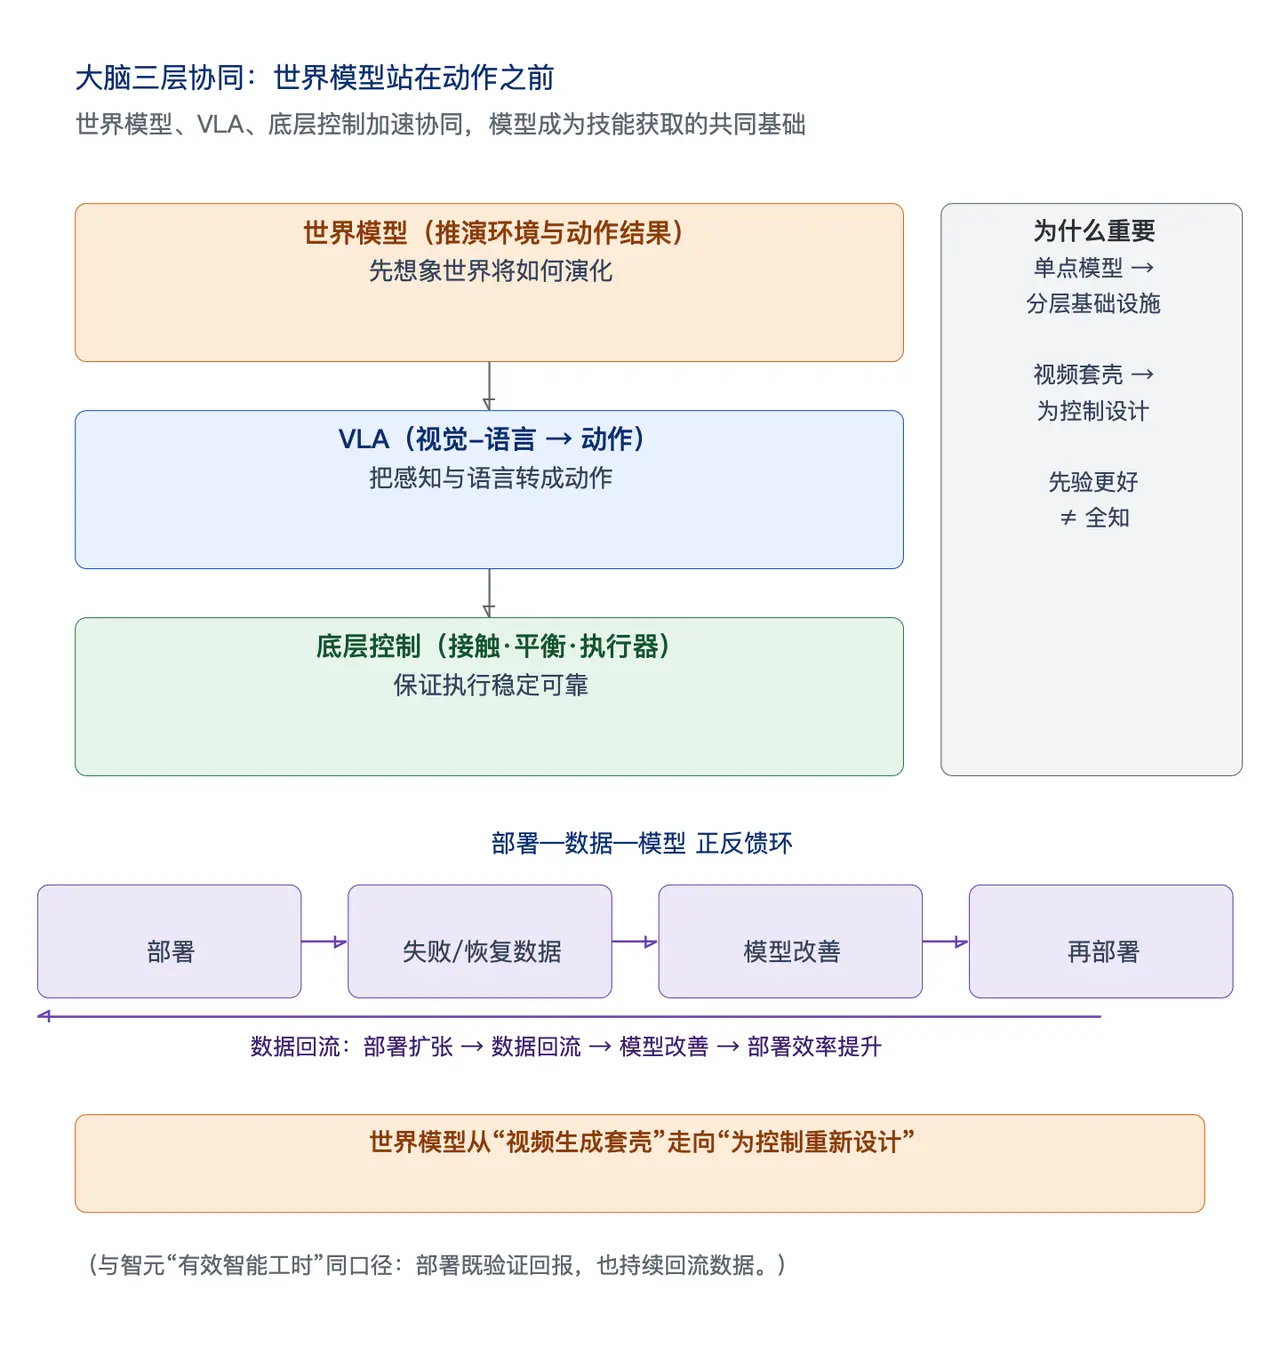
世界模型被推到动作之前,具体买到了什么?最直接的是“安全预算”:在真正驱动关节之前,先在表征里推演碰撞、跌落和接触失败,把危险场景挡在执行前;其次是“长尾数据生成”,给稀缺工况补出大量合成样本;再者是给智能体训练提供一个可交互的环境底座。国金证券同一周的研报,把Genie 4从离线视频生成升级为实时可交互世界模拟,视作同一趋势的旁证。
这也呼应了同一周学术侧的信号:多篇世界模型论文的演化主线,是从“视频生成器套壳”走向“为控制重新设计”——把表示单位从像素换成3D粒子、把尺度从隐式换成显式米制深度、甚至干脆扔掉生成骨干。GR00T 2的“预测未来帧+动作”正是这条工业落地线的最新一站。
这又回到产业正在算的那笔账。智元在创新日提出“有效智能工时”,把活跃机器人数量、自主工作时长和产出效能纳入统一评价;部署既验证硬件可靠性与客户回报,也持续产生失败、恢复与人工接管数据,形成“部署扩张—数据回流—模型改善—效率提升”的正反馈。世界模型让这条回路的起点更聪明,但回路本身仍要靠真实上岗来转。
但冷水要泼在合适的地方。公开口径也承认,GR00T 2的零样本稳定性与精细力控仍然有限;124毫秒延迟在高速接触场景里并不宽裕;它仍依赖示范数据,不是凭空学会。世界模型给的是更好的“先验”,不是“全知”。把它当成已经能替代老师傅,目前还早。
对 波士顿动力 、 银河通用 这类也在做全栈大脑和真实部署的玩家,WAM的出现不是抢戏,而是把“谁的数据能喂出会想象的大脑”这条竞赛线又往前推了一格。硬件趋同之后,真正的护城河正在收拢到“谁能更好地推演世界、谁掌握训练它的数据”。
英伟达 的打法也由此更清晰:用Cosmos做世界模型的底座、Isaac做训练与仿真、GR00T做动作模型、Thor做机载算力,四件套绑定成一条别人难以拆开的栈。 宇树 这类量产、接口开放的本体,则越来越像“commodity身体”——谁都能买来当试验台。
回到开头那次发布。GR00T 2和Turbo计划于2026年12月开源,并开放部分人类视频数据与仿真工具链。这意味着“先想象再动手”不会只停在论文和发布会,而会流进一大批开发者的真机里。从“会动”到“会想”,世界模型站在动作之前,是机器人大脑这场长跑的下一根栏杆。
本文基于公开报道整理。