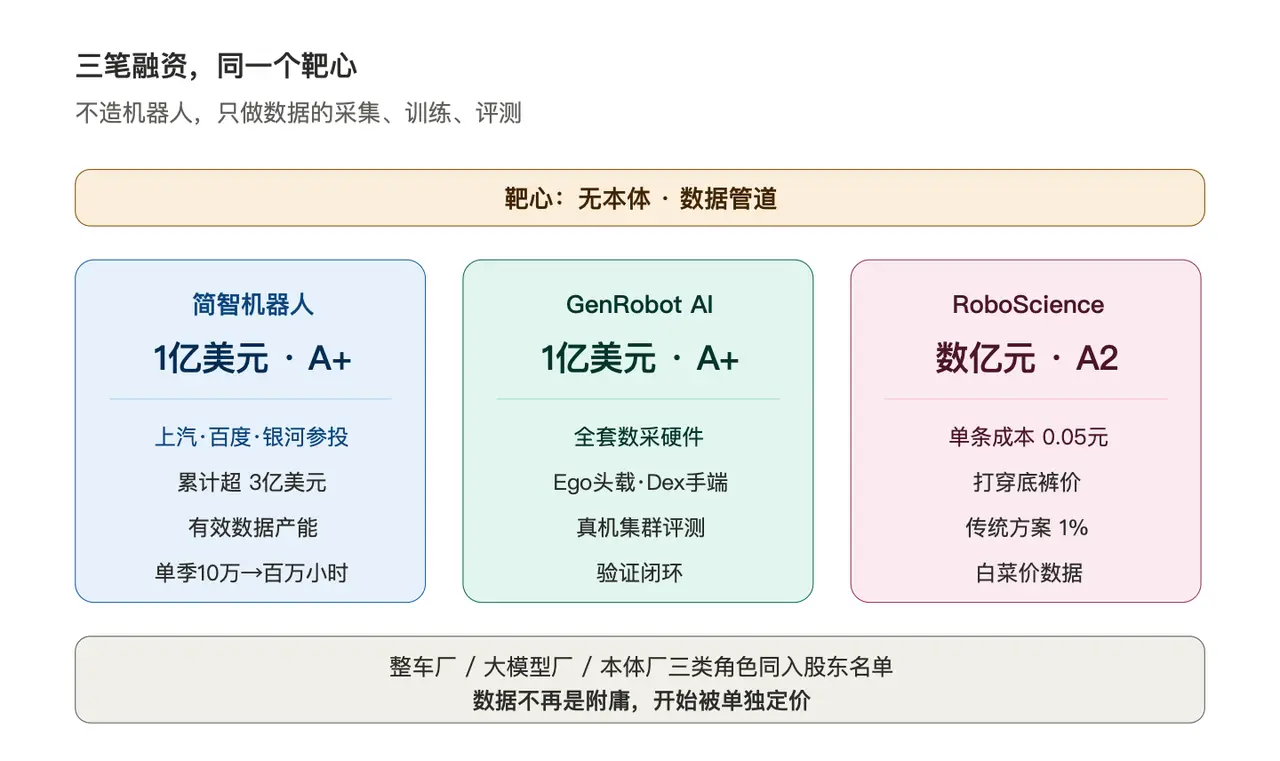
11月2日这一天,具身智能赛道发生了一件耐人寻味的事:简智机器人、GenRobot AI、RoboScience三家公司同获巨额融资,合计规模惊人。更关键的是,这三笔钱全部砸向了同一类公司——不造机器人本体的数据管道公司。放在两年前,这种事几乎不可想象。
简智机器人宣布完成1亿美元A+轮,上汽、百度、 银河通用 集体参投,其累计融资已超3亿美元,刷新了无本体数据公司的融资纪录。同一天,GenRobot AI也拿下1亿美元A+轮;RoboScience则完成数亿元A2轮。一天三笔,清一色指向教机器人干活的数据生意。
为什么是数据?过去,数据被整机厂视为成本项。像 特斯拉 这样的大厂,靠疯狂招人三班倒自己采集真实数据,代价极高。问题出在边际成本不降——你多采一小时真实数据,就得多付一小时的人工、设备和场景钱,账越算越平不了。
简智这类公司的出现,是把数据生产做成了可以规模化的独立生意。它不造机器人,只干三件事:人类技能数据采集、Data Foundation Model训练处理、真机集群评测验证。其交付的有效数据量,已经从单季度的十万小时,狂飙到了百万小时。
GenRobot的切入点是数采硬件:Ego头载设备、Dex手端采集设备,把怎么采做成标准化工具。RoboScience更狠,宣称把单条训练数据的成本压到了0.05元,直接干到传统方案的百分之一。当数据从天价变成白菜价,具身智能的商业闭环才真正有了可能。
三笔融资最值得玩味的,是股东名单的构成。上汽投简智,是为了产线数据;百度投它,是为了大模型训练; 银河通用 作为本体厂入局,则指向自身的训练需求。整车厂、大模型厂、本体厂三类完全不同的角色,同时出现在一家无本体公司的股东名单里。
这不是孤立事件。今年以来,行业里数据飞轮的提法被反复强调。 宇树科技 创始人王兴兴在近期论坛上的判断是:具身智能最大的瓶颈不是大模型的理解力,而是AI与物理世界最后几毫米的对齐误差,而破局的关键正是机器人自进化的数据飞轮——AI自主编写控制代码、在仿真与实物环境中训练、自主评价效果。
但数据的价值,最终要由真实工况回流来验证,而不是躺在仓库里的存量。一个绕不开的现实是:2026年上半年全球人形机器人出货量超2.2万台、同比暴涨近300%,但真正进入智能制造、仓储物流场景的仅约8%,超六成设备依旧停留在商演和科研教学场景。
少数跑出来的落地项目,已经用数据证明了飞轮能转。 乐聚 的夸父机器人在兆丰机电产线累计运行约1000小时,助力生产6万余个零部件,单次上料循环稳定在40秒以内,作业成功率稳定在98%。 银河通用 的重载机器人GalbotS1落地宁德时代产线,双臂搬运50公斤料箱,自验收后实现7×24小时连续运行。
这些数字说明,数据飞轮要转起来,靠的是部署现场持续产生的有效数据,而非一次性采买。机器人每完成一次真实任务,就在为下一次更稳、更快提供养料。这也是为什么有效数据量比数据总量更有含金量。
不过,有效数据目前仍是黑箱。简智说的是有效数据量,但100小时的脏数据,洗出来能剩几小时?如果转化率极低,背后的成本依然是天文数字。数据从天价被RoboScience打到白菜价,前提是清洗和标注的自动化足够成熟,否则低价只是账面游戏。
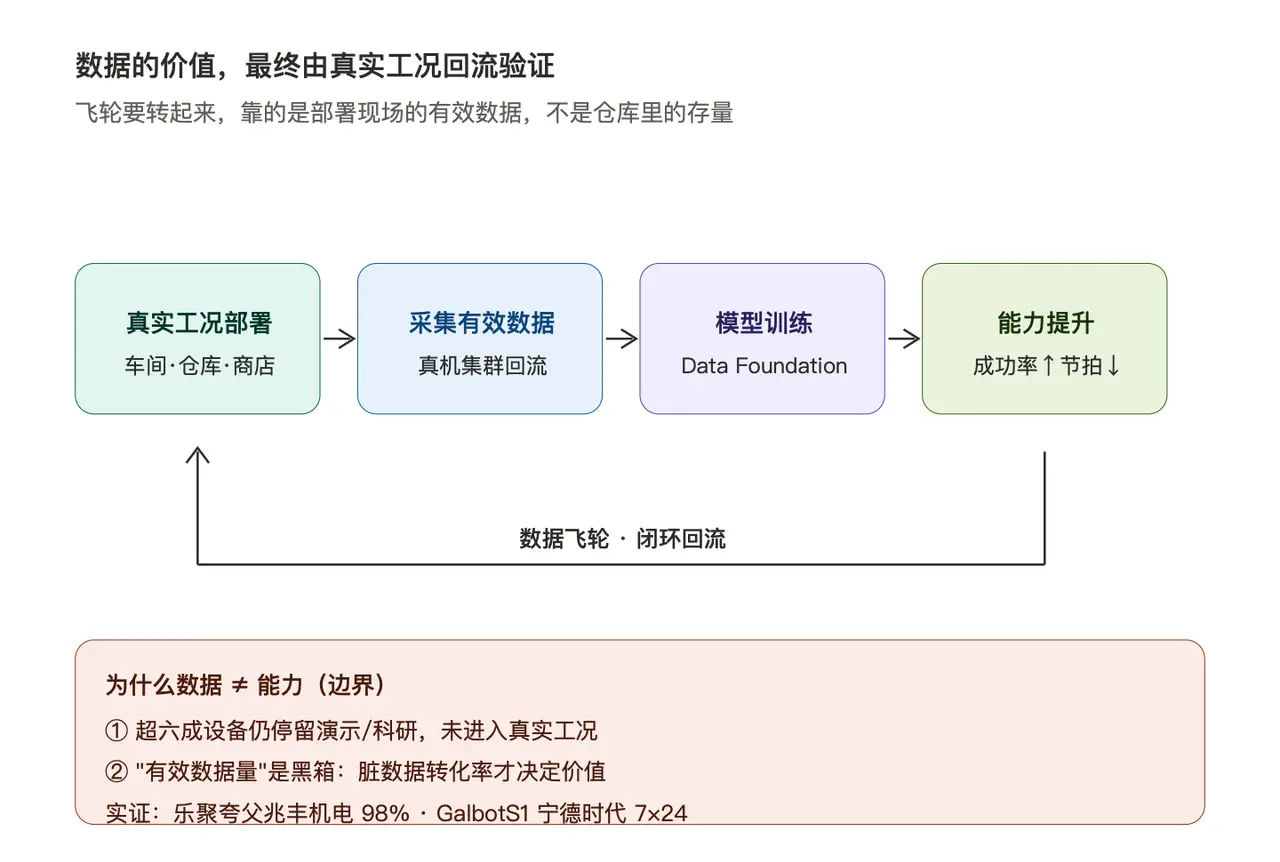
更本质的边界是:数据不等于能力。 智元机器人 、 优必选 、 Figure 、 波士顿动力 这类本体厂,真正的护城河不只是数据量,而是把数据转化为可靠作业单元的工程化能力。采购方的关注点早已从能翻多少跟头转向重复定位精度、负载能力、部署周期和连续运行稳定性。
站在 NVIDIA 这类底层算力与平台玩家的视角,数据基建的成熟反而是利好——更便宜、更充沛的数据,会加速端侧模型的迭代。但当资本把数据单独定价,本体厂也该重新审视自己的位置:如果数据可以外采,整机的差异化到底是身体、大脑,还是背后的工程化与场景理解?
舍弗勒 这类零部件巨头的处境提供了另一个注脚:当本体厂还在为找场景发愁时,它靠关节模组等零部件订单提前过冬。数据管道公司今天的融资热度,本质上是同一逻辑的另一面——在具身智能的价值链里,卖铲子的人,往往比挖金子的人更早拿到确定的钱。
当然,把数据资产化讲成确定性故事还为时过早。超八成项目仍停留在验证或演示阶段,行业连多少台算量产都还没共识。三笔融资是明牌,但不是终局。真正决定胜负的,是谁能先把数据飞轮在真实工况里转满一圈,并让客户愿意用订单投票。
对从业者来说,这一天的三笔融资最大的启示或许是:别只盯着本体厂的发布会。当资本开始给数据单独定价,底层基建的牌局已经翻开,而这张牌桌上,赢家未必是造机器人的那一个。
本文基于公开报道整理。