11月初,两件几乎同时发生的事,把具身智能领域争论了快两年的一个问题摆到了台面上:机器人的“大脑”到底该由谁、用什么方法造。
一边是Anthropic在11月9日发布的旗舰模型Fable5.2,在RoboDojo双臂操作基准上跑出64.9%的平均成功率,比上一代Fable5.1的27.6%高出37.3个百分点,也差不多是GPT-6Astra的29.8%的两倍多。
更扎眼的是做法:Fable5.2没有为机器人做任何专项训练,却凭“看画面、排动作”的通用能力,直接控制实体机械臂完成了画图案、拧瓶盖、解魔方三项从未专门训练过的任务。
另一边是 NVIDIA 在11月10日披露的GR00T2,走的是完全相反的路:预训练融合40.3万小时的人类第一视角视频、1万小时UMI夹爪数据与2.35万小时机器人遥操作数据,加入完整人类视频后,72项真机任务的平均完成进度从50%提升到70%。
同一个星期,两种“造大脑”的方法各交出一份成绩单,把行业逼到一道二选一面前:是让通用大模型跨界来接管机械臂,还是继续把专用VLA(视觉-语言-动作)模型喂饱数据?过去一年资本也明显从本体转向大脑,路透称2026年上半年中国具身智能融资935亿元、为上年同期五倍,资金更多流向AI软件开发商——大脑路线怎么选,直接决定这笔钱往哪条技术栈沉。
先说通用基座跨界这条线。它的核心赌注是:机器人操作需要的“看懂场景、排布动作”能力,本来就是通用大模型已经具备的世界知识的一部分,不必再从零训一个机器人专家。
Fable5.2的64.9%之所以被反复提及,正是因为它挑战了一个主流判断——过去大家默认“必须做专用VLA才能操控机器人”,而现在一个没碰过机器人数据的通用模型,仅靠泛化就切进了双臂精细操作。
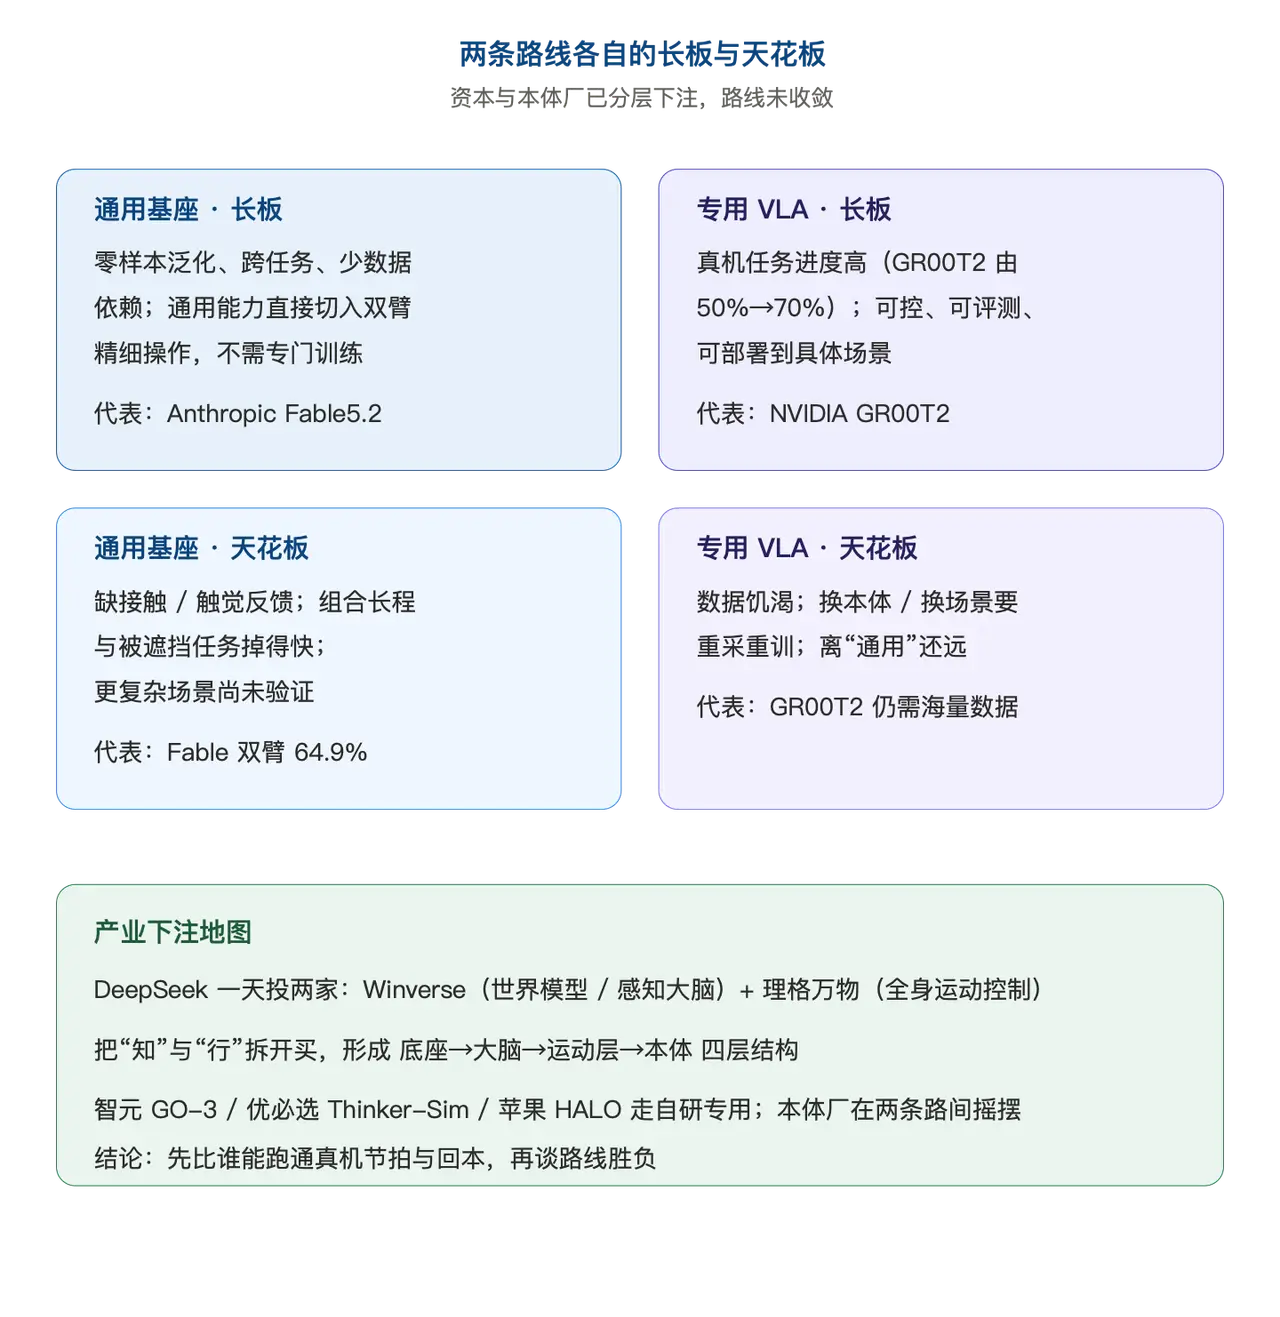
但这条线的天花板也很直白:它全程靠视觉感知,没有接触反馈。东西看得见就好办,一旦被遮挡、出了画面、需要靠手上的力道去判断,表现就往下掉。Fable5.2展示的画图案、拧瓶盖更接近“单步技能”,而真实工厂要的是几十步连起来不出错,这正是它尚未验证的部分。
论文里没有把复杂长程、被遮挡任务的成功率单独列出来,而Anthropic自己把触觉感知列为后续方向,等于承认了这块短板。泛化能补数据短板,却补不了“手感”。
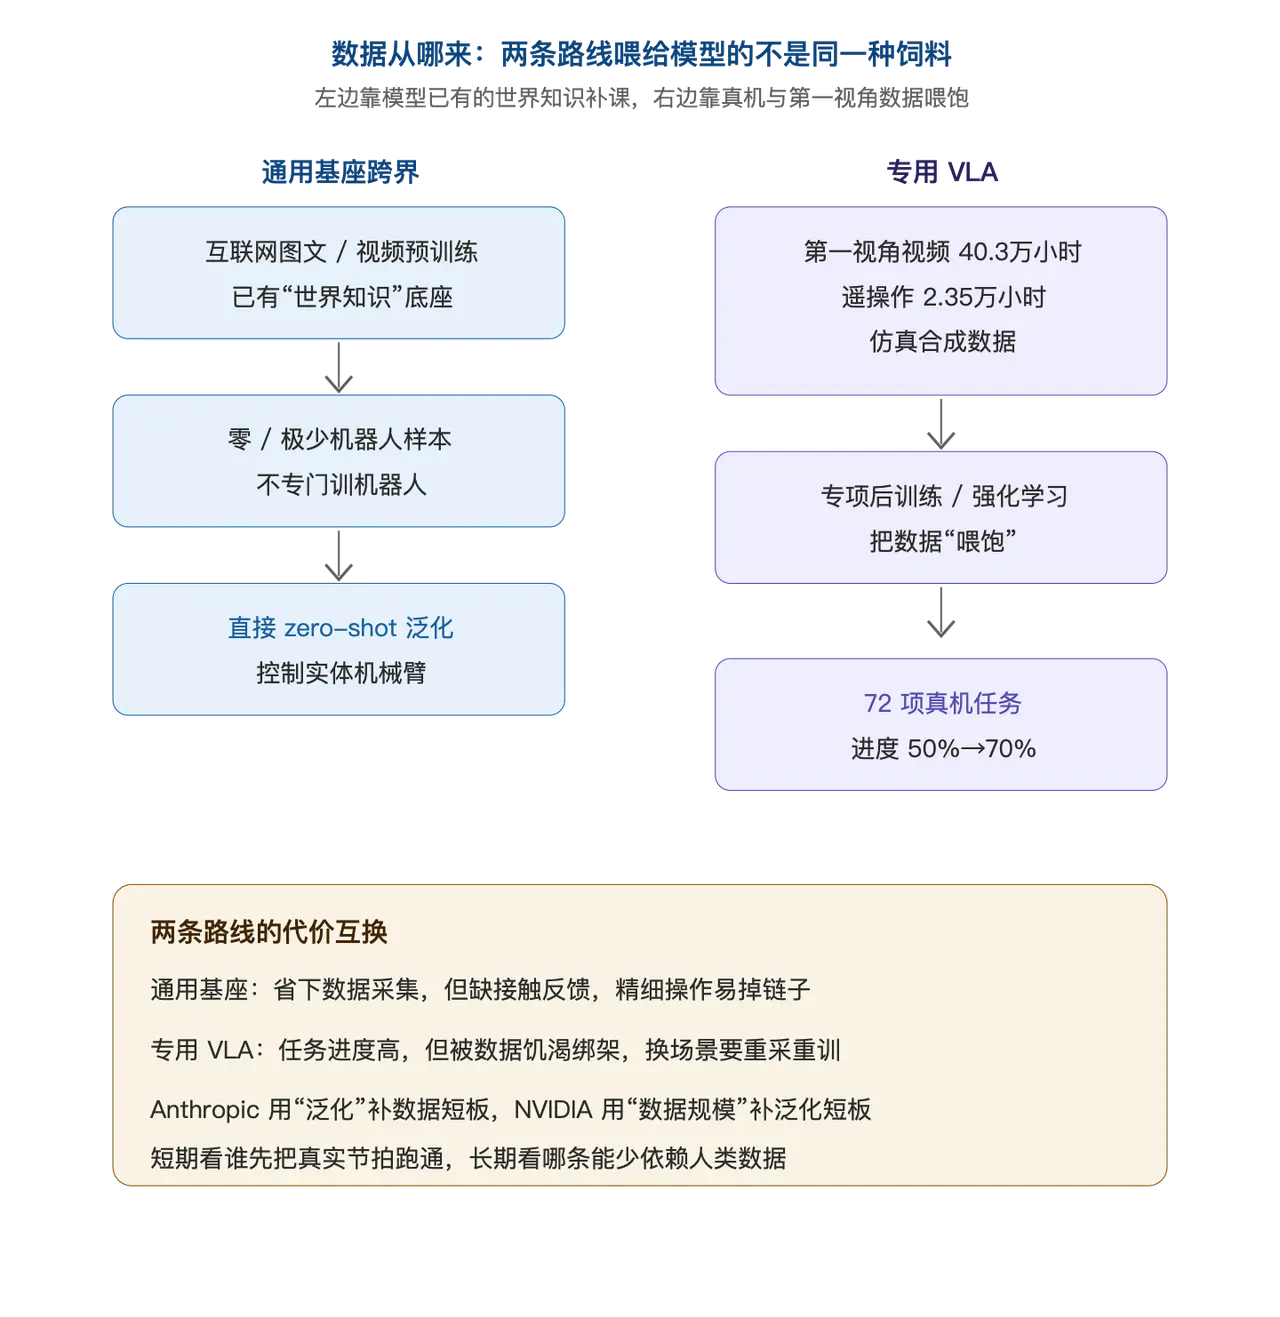
再看专用VLA这条线。 NVIDIA 的GR00T2代表了它的典型打法:用海量第一视角视频、遥操作和仿真数据做预训练与后训练,把模型“喂”到能在具体场景里稳定干活。
GR00T2把72项真机任务的平均进度从50%推到70%,靠的是数据规模,不是架构魔法。它的长板恰好是通用基座的短板:可控、可评测、能部署到具体场景,进度可量化。
代价是它被数据饥渴绑定:换一个本体、换一类任务,往往要重新采集、重新训练。离“一个模型通吃所有机器人”还远。
两条路线的分歧,本质不在“谁更强”,而在三件事:数据从哪来、要不要专项训练、泛化边界划在哪。一边押“通用模型跨界”,一边押“专用模型深耕”。一个常被忽略的点:两条路线对“数据”的定义也不同——通用基座想少要人类数据,专用VLA想多要真机数据,谁先把数据成本压下来,谁就掌握议价权。
资本已经在用钱投票。11月10日,DeepSeek一天投出两家具身智能公司:Winverse(前腾讯混元科学家胡瀚创立,方向是世界预测模型与多模态感知)和理格万物(前逐际动力控制系统负责人俞涛创办,主打全身动力学控制)。
这两笔投资互补得很清楚:一家解决“看懂场景、预判结果”,一家解决“把规划转成稳定安全的全身运动”,叠加上此前DeepSeek战略配售的 宇树 ,形成“大模型底座+世界模型大脑+运动控制层+机器人本体”的四层结构。
在国内, 智元 的GO-3Preview已打通预训练、后训练与部署后全链路, 优必选 在11月初发布Thinker-Sim仿真平台以Real2Sim2Real降低数据采集成本,苹果HALO则把“大脑”拆成三层跑在 宇树 G1上——头部本体厂大多选择自研专用路线,在两条路之间摇摆。
而 特斯拉 的Optimus、 Figure 的Helix,则把“大脑”列为走向实用的核心挑战,无论走哪条路,最终都得回到同一个考场:真机节拍、人工接管频次、单位合格作业成本。
结论不玄乎:路线远没有收敛。短期看谁先把真实节拍跑通、谁先能回本,长期看哪条路能更少地依赖人类数据。大脑之争,先从“能不能落地”算起,再谈“谁更通用”。
本文基于公开报道整理。